Spécialiste de la valorisation des données avec plus de 15 ans d’expérience, j’accompagne les organisations dans la transformation de leurs enjeux métiers en insights clairs, stratégiques et actionnables.
J’interviens de la structuration des données à leur restitution, en m’appuyant sur des environnements modernes et avec une expertise en modélisation, pipelines de données et visualisation.
Fondateur de Mont Blanc Data, j’adopte une approche de guide : tracer la voie, sécuriser les choix et rendre les objectifs atteignables grâce à une exploitation efficace et maîtrisée de la donnée.
Mon objectif reste inchangé : rendre la donnée claire, accessible et porteuse de valeur.
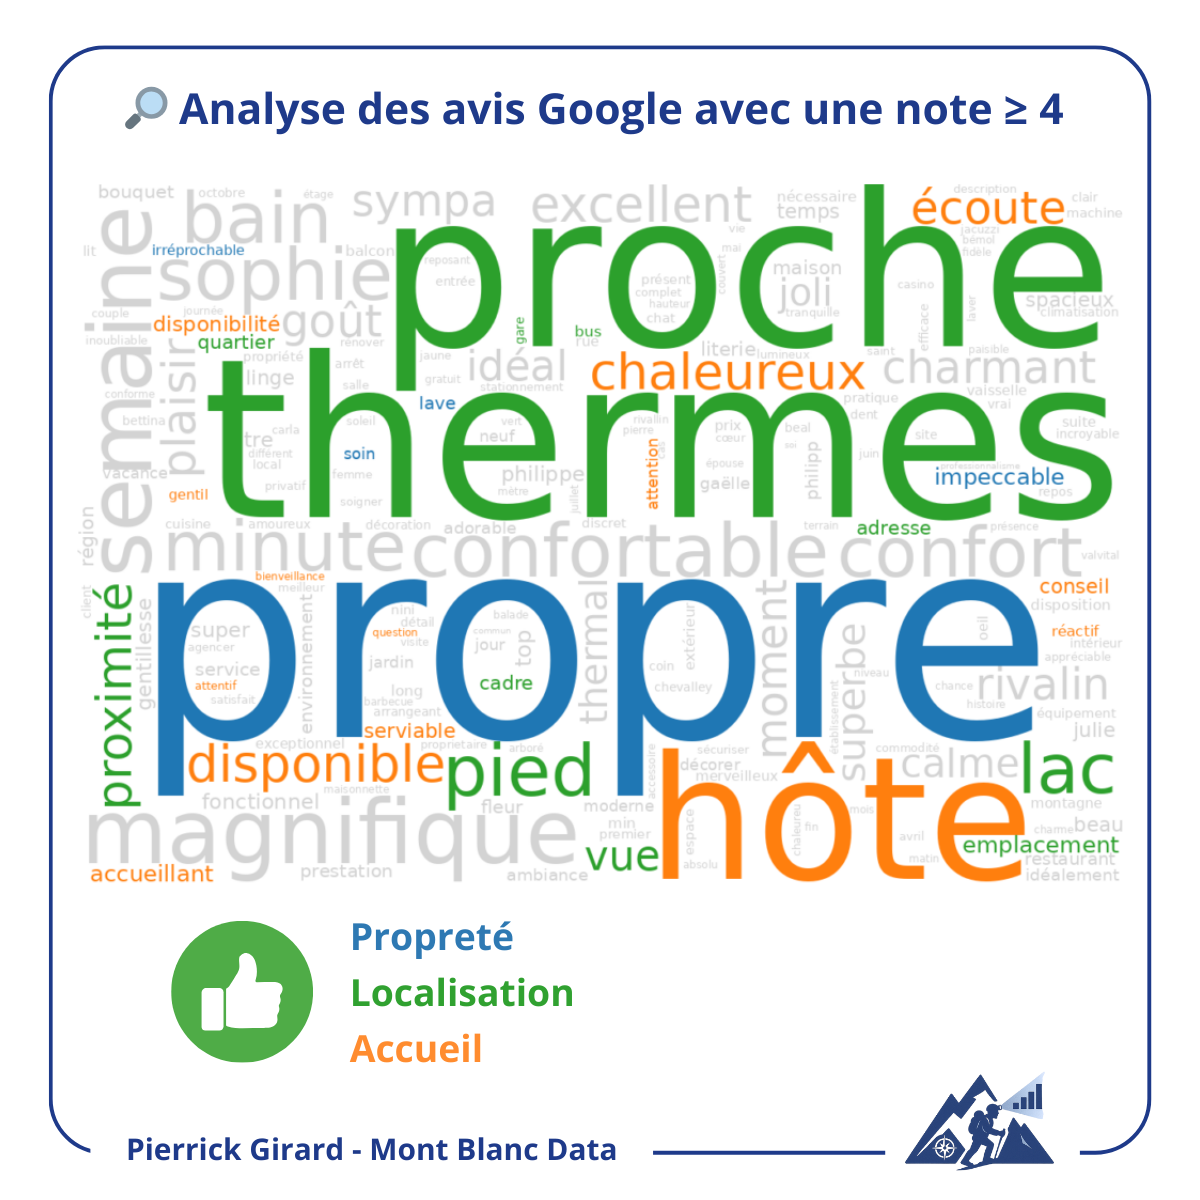
Analyse des avis Google pour les hébergements d’Aix-les-Bains
- Contexte
- Étude des avis Google pour identifier les atouts et irritants de l’hébergement touristique à Aix-les-Bains, afin de transformer la voix des clients en leviers d’action.
- Détails techniques
- Collecte via API Google & SerpAPI, pipeline NLP (spaCy, lexiques, clustering KMeans), visualisations (bar charts, wordclouds) pour dégager les thèmes saillants.
- Compétences clés
- Scraping, NLP appliqué en français, clusterisation (KMeans), visualisation avancée, storytelling analytique.
- Réutilisation client
- Baromètre e-réputation, suivi de la satisfaction et des irritants, appui aux offices de tourisme et extension multi-plateformes (Booking, Airbnb).
Voir le code sur GitHub
Voir le post LinkedIn — Scraping
Voir le post LinkedIn — NLP
Simulation du problème de Monty Hall
- Contexte
- Célèbre paradoxe de probabilité où un choix apparemment aléatoire ne l'est pas. Le projet illustre comment la data valide ou corrige nos intuitions.
- Détails techniques
- Script Python simulant des milliers de parties, calcul des taux cumulés de victoire (garder vs changer) et génération d’un GIF animé montrant la convergence vers les probabilités réelles.
- Compétences clés
- Simulation aléatoire, pandas & numpy, animation matplotlib, pédagogie statistique.
- Réutilisation client
- Démos pédagogiques pour vulgariser la probabilité et l’incertitude, illustrations interactives pour la formation ou la communication data.
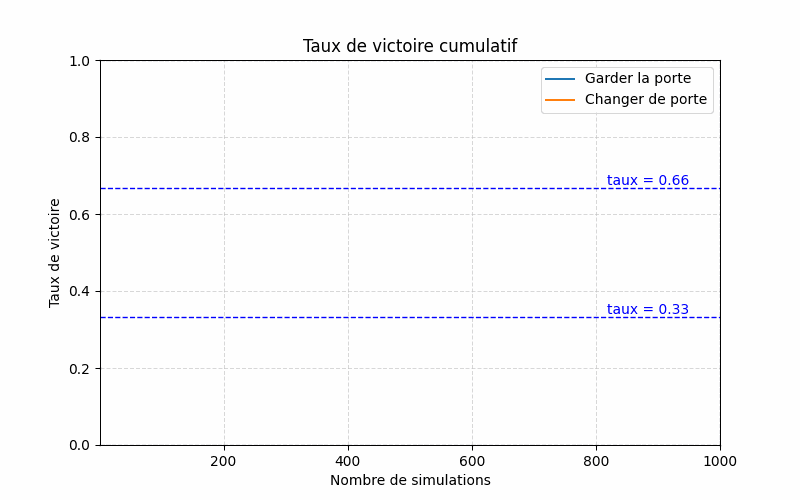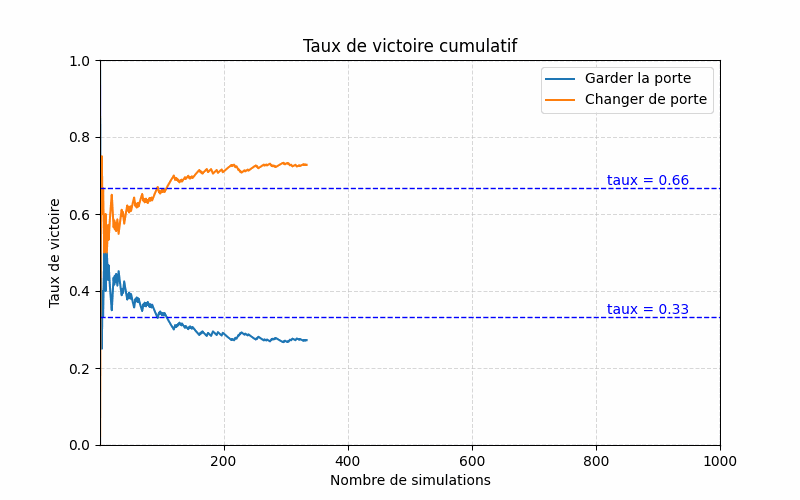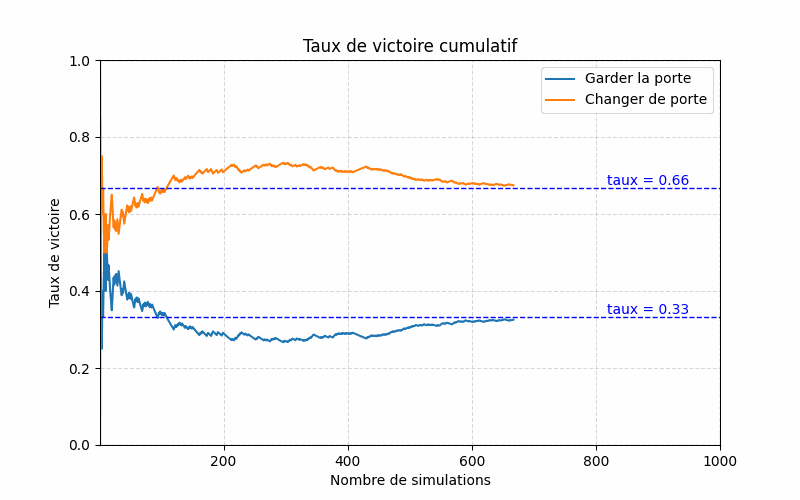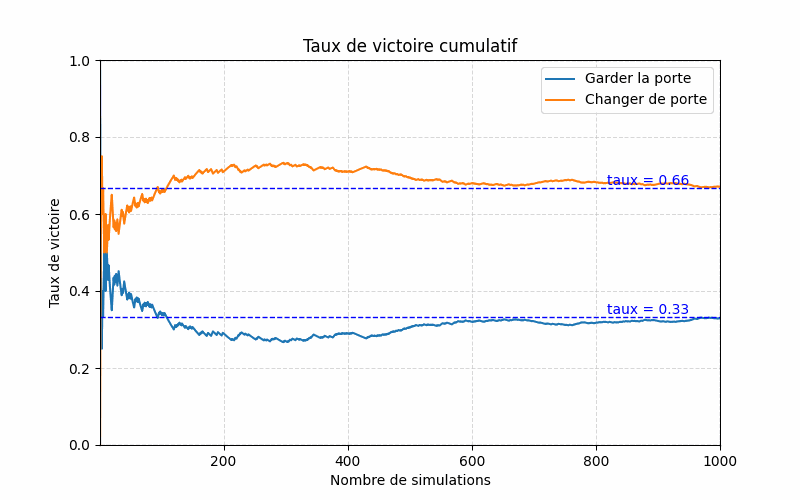
Voir le code sur GitHub • Voir le post LinkedIn
Illustration du paradoxe de Simpson
- Contexte
- Simulation réaliste de données de randonnée pour un territoire de montagne afin d’illustrer un paradoxe statistique : des tendances inversées apparaissent entre analyse globale et segmentation par profils de randonneurs.
- Détails techniques
- Génération de données cohérentes (temps, D+, distance, profils), filtrage et garde-fous, visualisations avec régressions linéaires globales vs sous-groupes. Librairies : numpy, pandas, scikit-learn.
- Compétences clés
- Simulation de données, régression, visualisation avancée, détection de variables de confusion, data storytelling pédagogique.
- Réutilisation client
- Fiabilisation d’A/B tests, meilleure lecture des KPIs agrégés, mise en évidence d’effets de confusion pour éviter des décisions erronées.
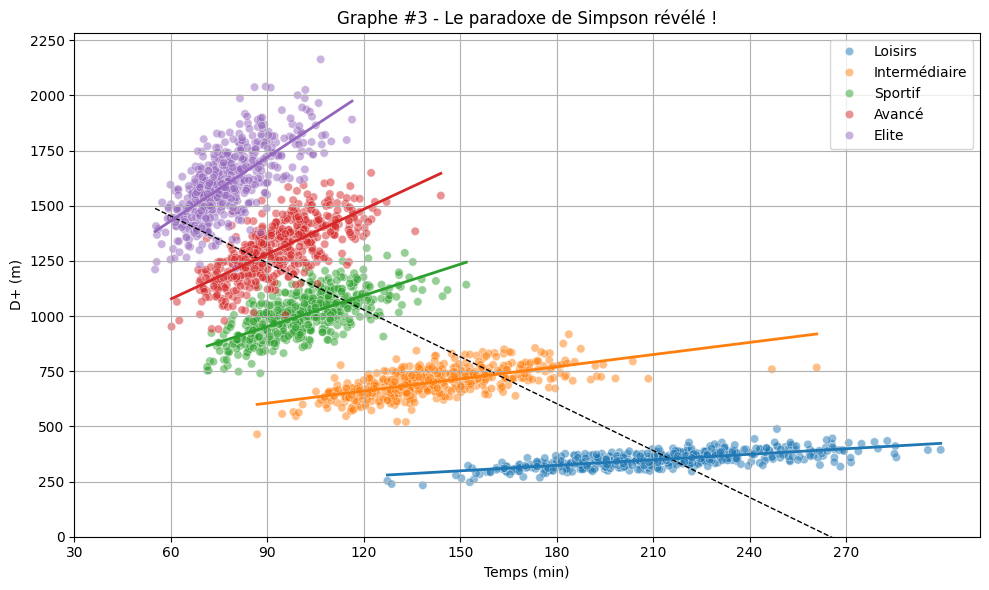
Voir le code sur GitHub • Voir le post LinkedIn
EuroMillions — Pipeline de nettoyage & dataviz
- Contexte
- À partir d’un fait d’actualité (jackpot record), analyse des tirages historiques pour montrer comment structurer et valoriser des données publiques.
- Détails techniques
- Mise en place d’une chaîne raw → silver → gold (zip, CSV, pandas), nettoyage avancé (dates, encodages, doublons), consolidation puis analyse statistique des fréquences. Visualisations professionnelles (dégradés, format carré optimisé pour LinkedIn).
- Compétences clés
- Data cleaning robuste, pipeline structuré, pandas, matplotlib, storytelling visuel.
- Réutilisation client
- Mise en production rapide de mini-pipelines, contrôles qualité des données, création de visuels prêts à partager avec métiers/marketing.
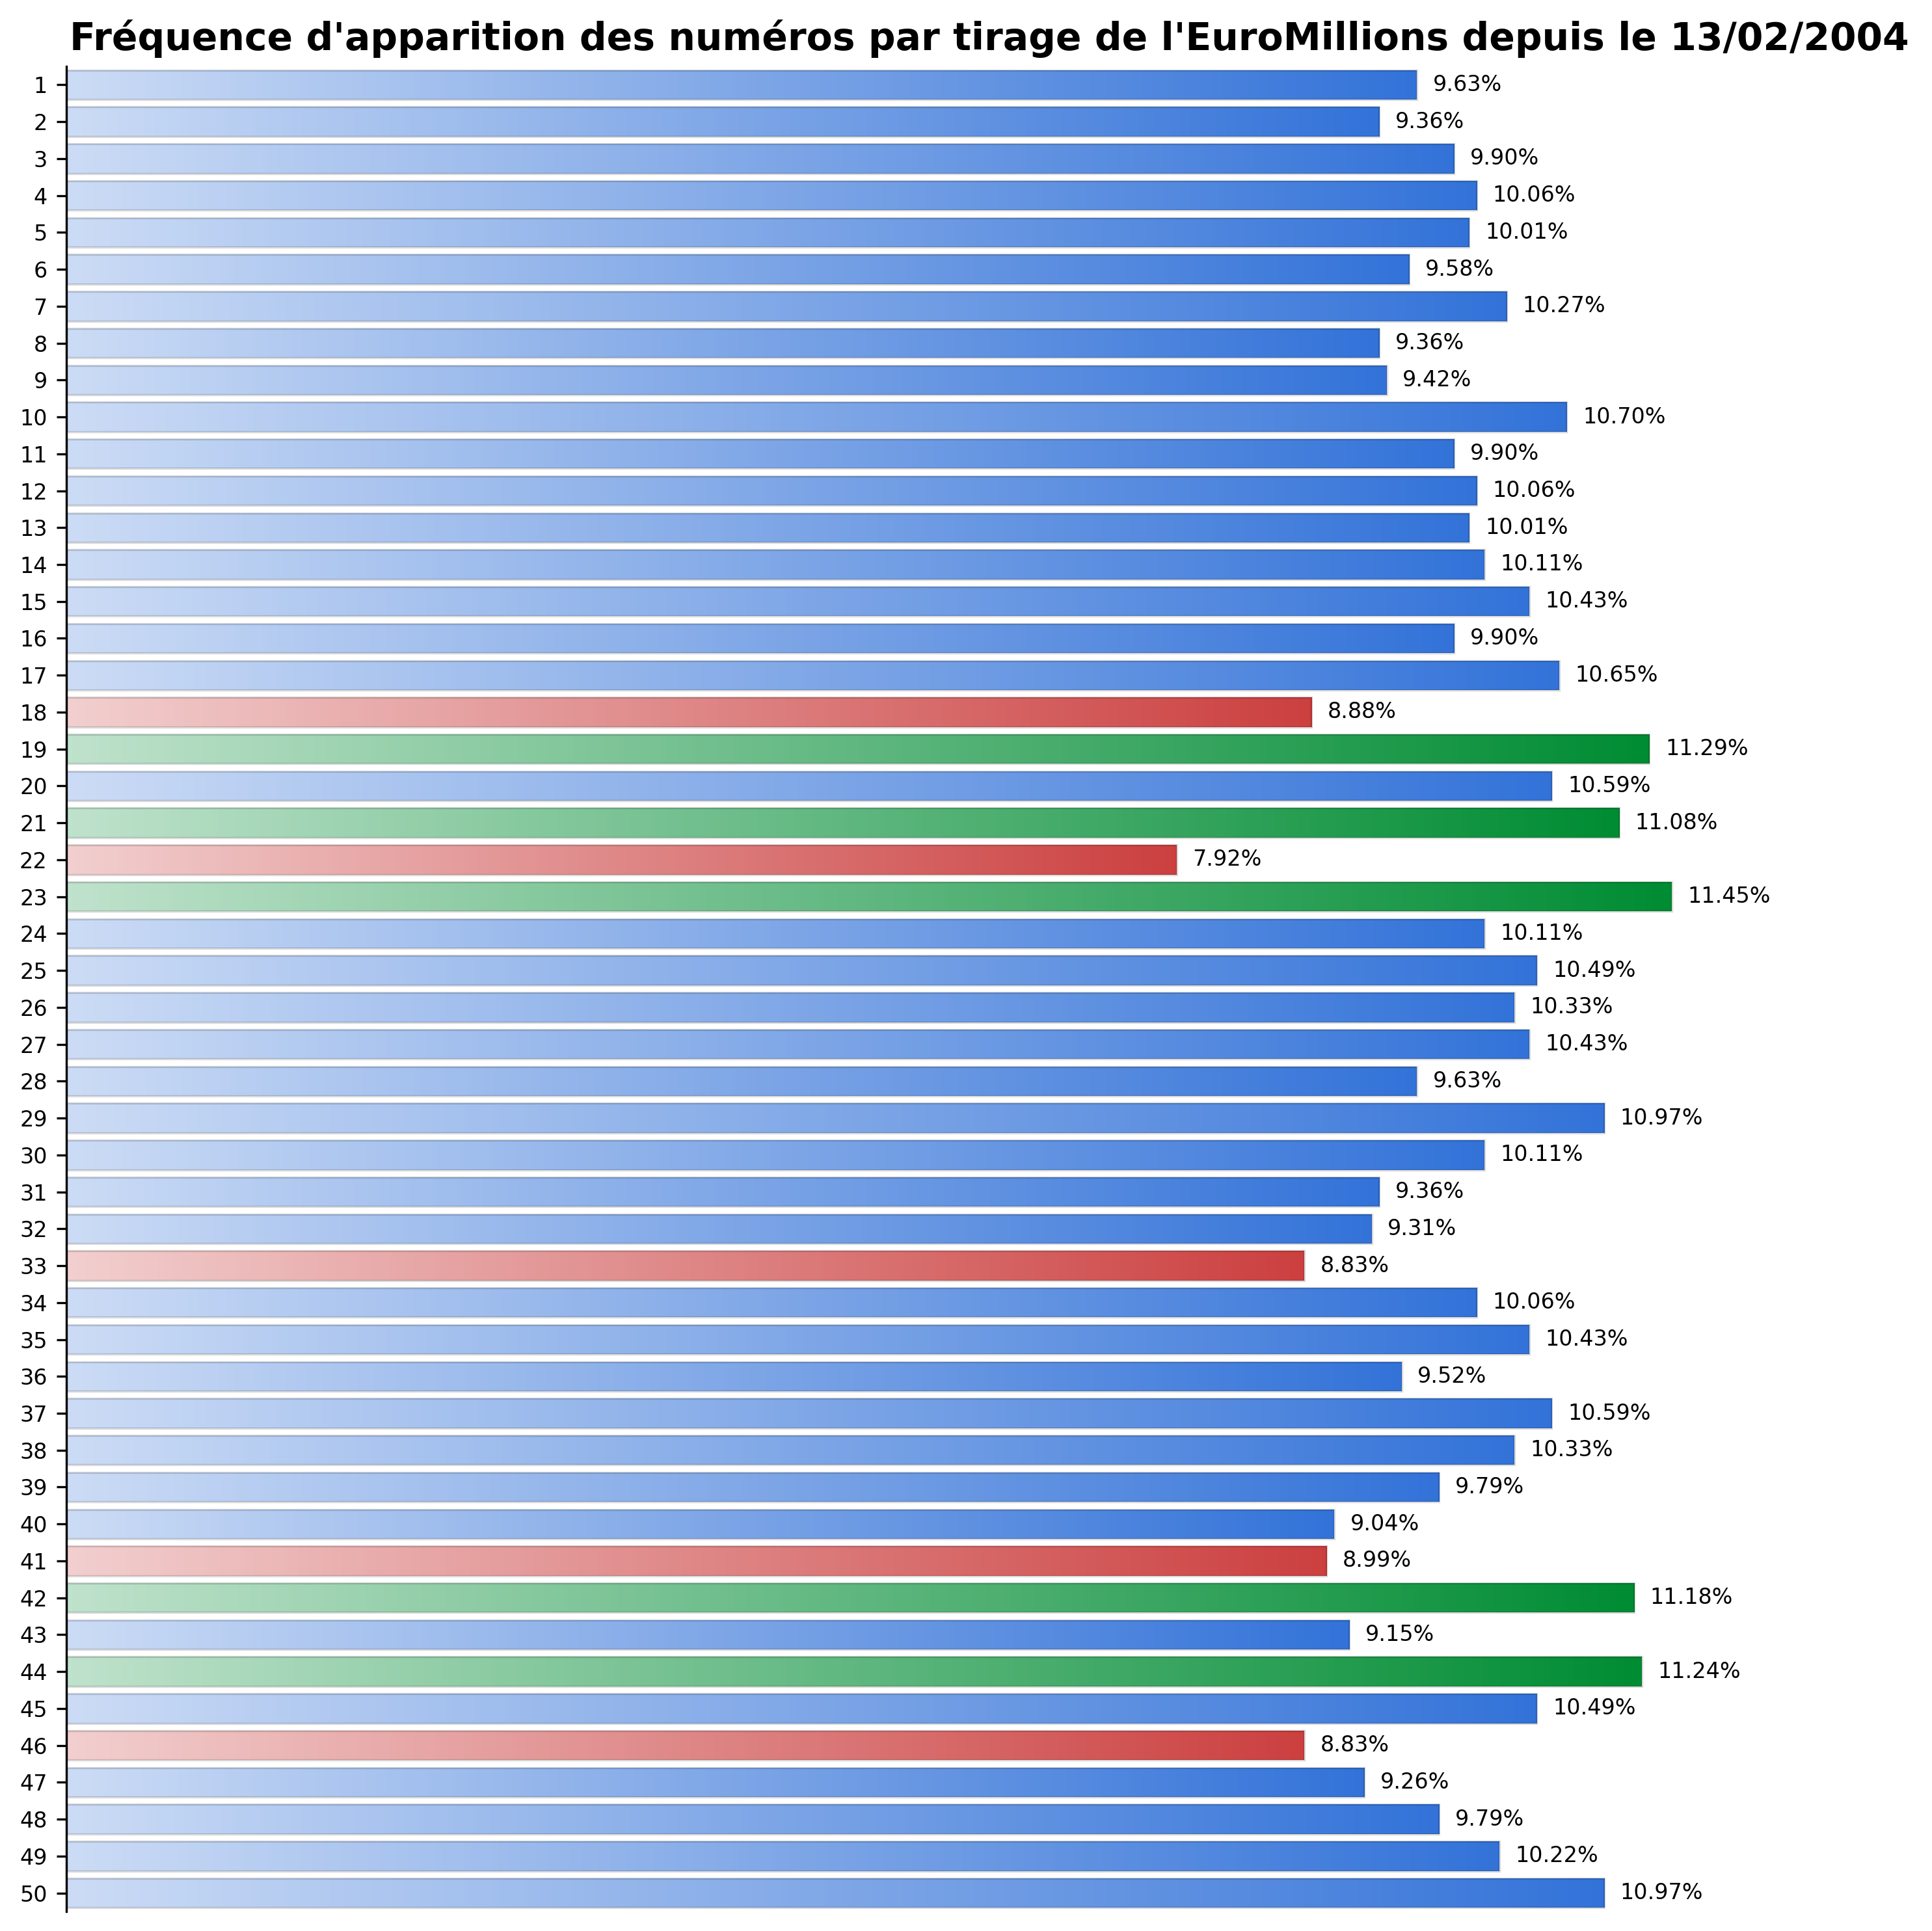
Voir le code sur GitHub • Voir le post LinkedIn
Power BI — Bonnes pratiques & astuces pédagogiques
- Contexte
- Série de cas concrets publiés sur LinkedIn pour illustrer des limites ou subtilités de Power BI (absence d'expressions régulières, calculs ligne précédente, cellules fusionnées). Objectif : transmettre des solutions pratiques et montrer mon rôle de formateur.
- Détails techniques
- Extraction de motifs sans regex native, calcul de variations (i+1 – i), gestion des cellules fusionnées Excel.
- Compétences clés
- Power Query M, intégration Python dans Power BI, data cleaning avancé, design de solutions sous contrainte, vulgarisation pédagogique.
- Réutilisation client
- Formation et accompagnement des équipes BI, conception de modèles plus robustes, transmission de bonnes pratiques Power Query, optimisation des environnements Power BI corporate.
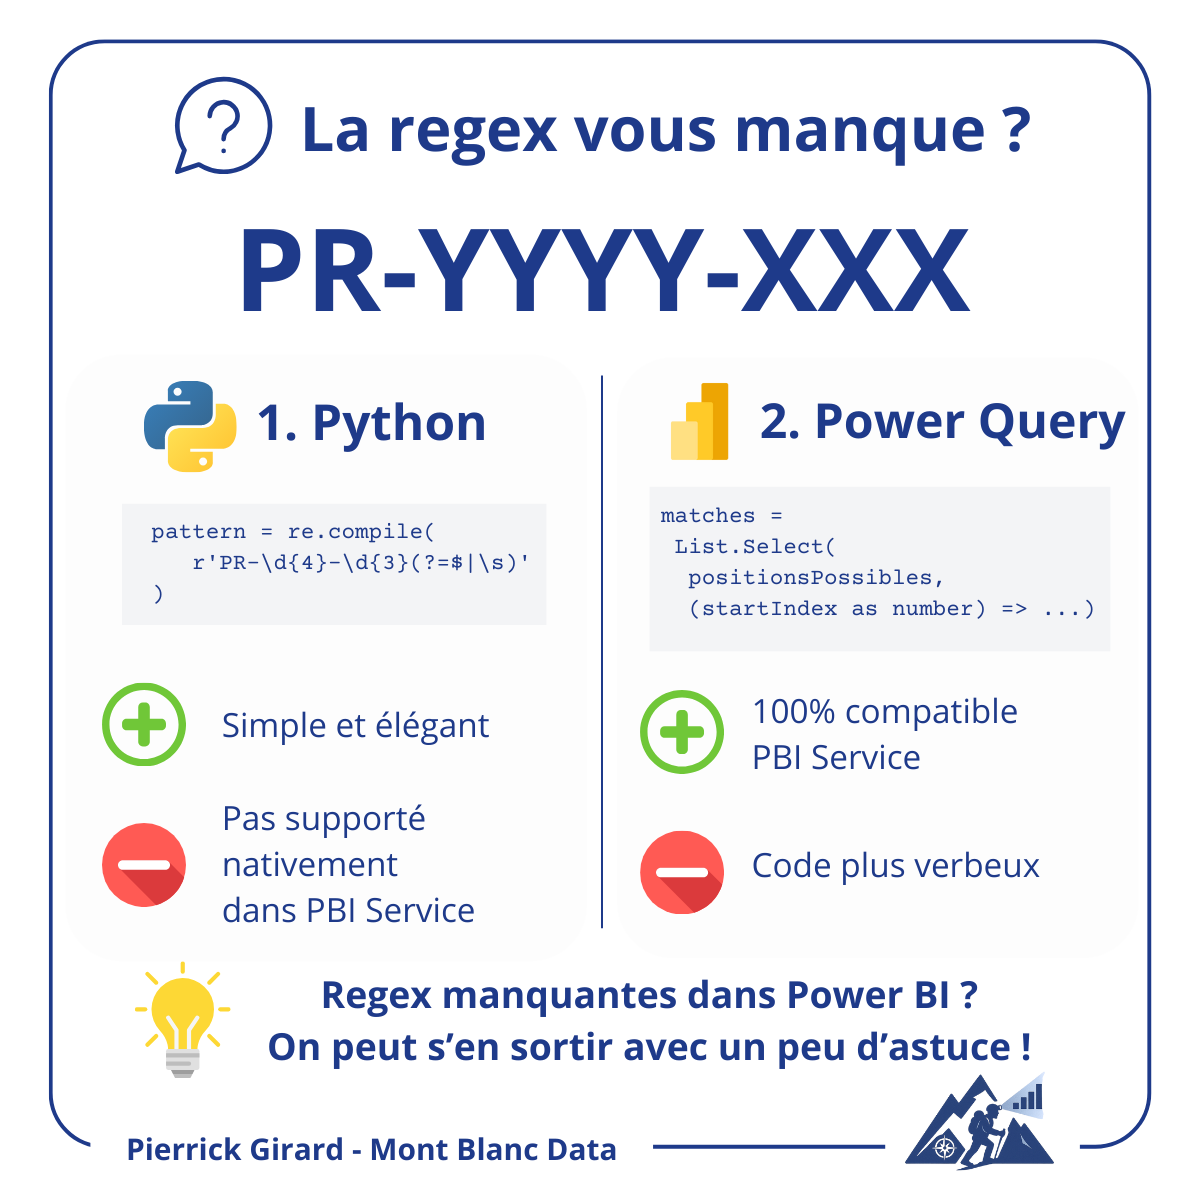
Voir le code sur GitHub — Regex
Voir le code sur GitHub — Index+List
Voir le code sur GitHub — FillDown
Voir le post LinkedIn — Regex
Voir le post LinkedIn — Index+List
Voir le post LinkedIn — FillDown